HCP Terraform 项目级 Run Tasks:扩展治理与一致性
概述
在云原生和基础设施即代码(IaC)的规模化实践中,保持治理策略的一致性并降低运维负担是 SRE 和平台团队的核心挑战之一。Hashicorp Cloud Platform (HCP) Terraform 作为主流的托管型 Terraform 平台,其 Run Tasks 功能允许在基础设施变更生命周期中集成外部工具(如安全扫描、合规性检查、成本分析等),以实施必要的控制。然而,此前该功能仅能在组织(Organization)或单个工作空间(Workspace)级别配置。对于管理数百甚至数千个工作空间的平台团队而言,这种粒度在规模化场景下会导致显著的运维摩擦。
近期,HCP Terraform 引入了 项目级 Run Tasks,这一更新将治理控制的边界从全局或单个工作空间,扩展到了 项目(Project) 这一逻辑分组层。项目是 HCP Terraform 中介于组织和工作空间之间的组织单元,用于按应用、业务单元或环境对基础设施进行归类。此新能力使平台团队能够将安全、合规和运维工作流(统称为“策略”)自然地与基础设施的组织结构对齐,并通过自动继承机制确保一致性,从而大幅提升治理的可扩展性。
核心概念
理解此功能需要掌握以下几个关键概念:
- Terraform Run Tasks: Run Tasks 是 HCP Terraform 运行生命周期中的集成点。它允许用户在特定的生命周期阶段(如
pre-plan、post-apply等)触发预定义的 HTTP 回调,从而与第三方服务(如 Snyk、Trivy、Cost Estimation 工具等)或内部自定义服务进行交互。这可以用于实施强制检查,如果外部服务返回失败,将阻止 Terraform 运行继续进行。 - HCP Terraform Projects: Project 是 HCP Terraform 中的一种组织结构。它提供了一个层级,用于将相关的 Workspaces 分组在一起,通常反映团队、应用或环境边界。项目本身也拥有自己的设置和权限。
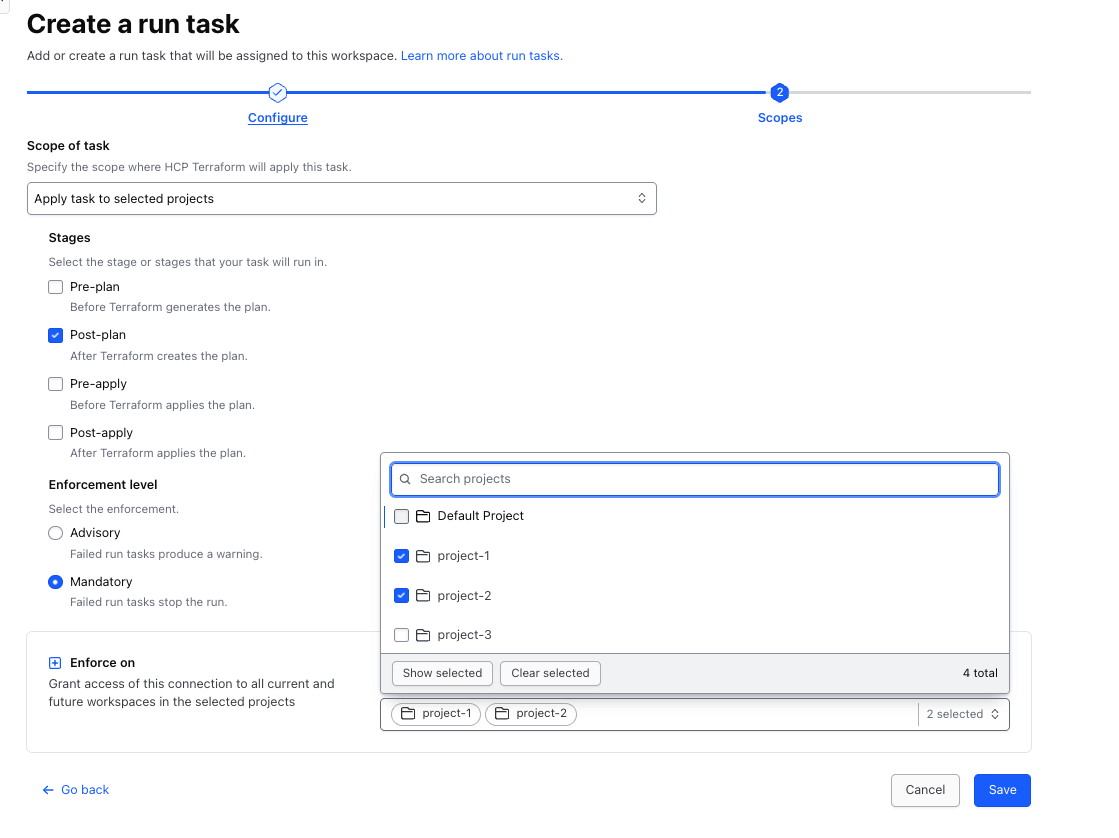
- 项目级 Run Tasks: 这是此次更新的核心。它允许在 Project 范围内定义和附加 Run Tasks。任何被创建在该项目下,或被移动到该项目中的 Workspace,都会自动继承在项目级别配置的 Run Tasks。这实现了从组织范围的全局设置到工作空间范围的具体设置之间的 中间层治理。
- 继承与覆盖: 项目级配置创建了一个策略继承模型。工作空间默认继承其所属项目上配置的 Run Tasks。这提供了“默认安全”的保障。同时,为了保持灵活性,可能允许在工作空间级别进行特定的覆盖或排除,以适应边缘情况。
实践
在典型的平台工程实践中,项目级 Run Tasks 的应用通常遵循以下模式:
- 定义治理边界:首先,平台管理员根据组织的合规要求和团队结构,在 HCP Terraform 中规划项目。例如,可以创建
production-apps、staging-apps和shared-services等项目。 - 配置项目级 Run Tasks:在
production-apps项目中,管理员配置一组 Run Tasks,例如:post-apply阶段:连接到公司内部的 CMDB 系统,自动更新资产信息。pre-plan阶段:调用公司的成本估算服务,对生产环境的计划变更进行成本分析。post-apply阶段:触发生产环境的冒烟测试流水线。
- 自动应用与一致性:当开发者在
production-apps项目下创建新的 Workspace 来部署一个生产应用时,该 Workspace 在每次terraform plan和terraform apply运行时,都会自动执行上述三个 Run Tasks。无需开发者手动配置,也无需平台团队为每个新 Workspace 重复设置。 - 管理 Workspace 继承:如果一个现有 Workspace 从
staging-apps项目移动到production-apps项目,它会立即开始继承项目级的 Run Tasks,从而自动升级其治理策略,确保生产环境始终受到更严格的检查。
关键收益:
- 提高速度与可扩展性:平台团队从繁琐的逐个工作空间配置中解脱出来。新工作空间的创建和环境迁移的治理策略应用变得自动化。
- 降低风险与提高一致性:策略的自动继承最大限度地减少了配置漂移(Configuration Drift)。安全、合规和运维标准在项目内的所有环境中得到一致执行。
SRE 要点
对于 SRE 团队而言,项目级 Run Tasks 带来了显著的实践提升:
- 与可靠性和可观测性的关联:通过将可靠性检查(如金丝雀部署验证、健康检查)作为 Run Tasks 集成到部署管道中,SRE 可以确保每次变更都自动符合可靠性标准。这增强了部署的可控性和可观测性。项目级配置使得这些可靠性“护栏”能以项目为单位进行规模化管理和审计。
- 事件响应:一致的、项目级的治理减少了因配置不一致导致的事故可能性。当事件发生时,基于项目结构的策略清晰度也有助于更快地定位受影响的工作空间范围和相关的控制点。
- 最佳实践与反模式:
- 最佳实践:
- 渐进式应用:先从非关键项目(如开发或测试环境)开始应用项目级 Run Tasks,验证其影响后再推广到生产环境。
- 明确责任:清晰定义项目级 Run Tasks 由哪个团队(通常是平台/SRE团队)维护,以及任务执行失败时的处理流程(如是否阻塞部署、通知谁)。
- 监控任务状态:监控 Run Tasks 本身的执行成功率和延迟,将其作为平台可靠性的 SLI 之一。
- 常见反模式:
- 忽略项目间差异:试图用同一套严格的 Run Tasks 强制应用于所有项目(包括开发环境),导致开发体验严重下降。应利用项目的隔离特性实施分级治理。
- 配置不透明:Run Tasks 的配置和失败原因没有清晰的文档和日志,导致开发者在部署受阻时不知所措。
- 最佳实践:
- 相关指标(SLI/SLO/SLA):
- SLI:Run Tasks 的执行成功率(成功次数/总执行次数)、执行延迟(从触发到完成的耗时)。
- SLO:可以为关键的生产级 Run Tasks(如安全扫描)设定 SLO,例如“每月执行成功率 > 99.5%”或“95%的执行在60秒内完成”。
- SLA:这是平台团队对其内部客户(开发者团队)的承诺,与上述 SLO 相关。确保治理检查的可用性和性能不会成为基础设施变更的瓶颈。
通过采用项目级 Run Tasks,SRE 和平台团队能够构建一个更强大、更一致且更易于扩展的 IaC 治理框架,从而在保障基础设施可靠性的同时,赋能开发团队高效交付。有关配置详情,请参阅 hcp-terraform 和 terraform-run-tasks 文档。